

前幾天我們先把 AI 助教的基本架構、介面以及教學規則處理好,今天想再往前走一步。
如果學生回答錯了,AI助教不能只跟他說「答錯了,正確答案是 B」,因為很多時候,學生答錯並不是單純粗心,而是他腦中已經建立了一套錯誤的理解方式。
所以今天的目標,就是讓 AI 助教多一個能力:找出學生到底是哪個觀念搞錯了。
這次我們在後端 API 加入「盲點診斷(Misconception Diagnosis)」機制,讓 Gemini 在分析學生回答後,不直接公布答案,而是先判斷學生可能卡在哪個觀念,再透過引導問題慢慢把他帶回正確的思考方向。
首先,我先用程式設計中很常見的變數引用問題來測試。
我刻意讓學生輸入一個具有典型迷思的,誤將「變數共享同一個物件的參考」理解成「複製出一份獨立的值」
如果只是單純判斷對錯,其實這題並不難;真正比較有意思的是,AI 能不能進一步說明:
「你為什麼會得到這個答案?」
接著我想確認這套機制是不是只能用在程式設計。
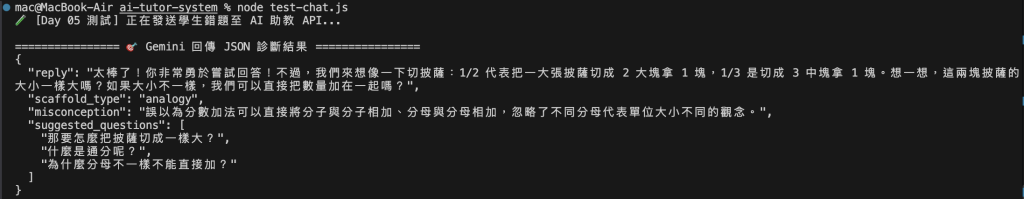
所以第二個測試直接換成國中數學,測試「異分母分數加減」這種很常見的錯誤。
例如學生可能會認為:
分子加分子、分母加分母就好了。
這時候 AI 不應該直接告訴他答案,而是要先發現:
學生其實沒有理解「通分」是在把不同大小的單位轉換成相同單位。
因此這次我利用 Gemini 的 Structured Output(JSON Schema),把這些原本比較抽象的「盲點診斷」轉成固定格式的 JSON,讓後端之後可以直接交給前端或 Firebase 使用。
[學生輸入錯誤回答]
       │
       ▼
[Express API 伺服器]
       │
       ▼ (呼叫 Google GenAI SDK + 盲點診斷 System Instruction)
[Gemini 3.6 Flash]
       │
       ▼ (解析思考邏輯,產出診斷 JSON)
{
  "scaffold_type": "misconception_diagnosis",
  "misconception": "誤將 Reference Copy 理解為 Value Copy",
  "reply": "你注意到了修改 b 的動作!不過在 Python 中...",
  "suggested_questions": [...]
}
首先修改 Express 後端的 responseSchema。
原本的 scaffold_type 只有:
scaffold_type: {
  type: 'string',
  enum: ['analogy', 'breakdown', 'quiz']
}
這次新增:
scaffold_type: {
  type: 'string',
  enum: ['analogy', 'breakdown', 'quiz', 'misconception_diagnosis']
},
misconception: {
  type: 'string',
  description: '學生的迷思概念摘要,無盲點填 None'
}
這樣做的原因很簡單:
我希望 Gemini 不只是回傳一段文字,而是把「學生的盲點」也當成一個獨立的資料欄位回傳。
之後不管是前端顯示、Firebase 儲存,甚至未來做學習分析,都可以直接使用這個欄位。
同時,我也在 System Instruction 裡加入規則:
當學生回答錯誤或觀念混淆時,不可以直接公布答案,而是要先分析學生的思考盲點。
如果學生本身回答正確,或只是一般問題,就把 misconception 設成 "None"。
除了讓 Gemini 回傳固定格式之外,我也順手處理了一個比較容易被忽略的問題。
如果 API 回傳的格式真的出了問題,原本的 fallback 資料沒有 misconception 欄位:
parsedData = {
  reply: response.text,
  scaffold_type: "analogy",
  suggested_questions: [...]
};
這樣前端如果預期一定有 misconception,拿不到這個欄位時就可能需要額外處理,甚至造成後續顯示錯誤。
所以我把它補上:
parsedData = {
  reply: response.text,
  scaffold_type: "analogy",
  misconception: "None",
  suggested_questions: [...]
};
這個修改看起來很小,但對 API 來說其實滿重要的。
因為結構化資料最重要的不只是「正常時能不能跑」,而是格式偶爾出問題時,整個系統能不能繼續運作。
test-chat.js):學生錯誤輸入:

Gemini API 診斷結果:
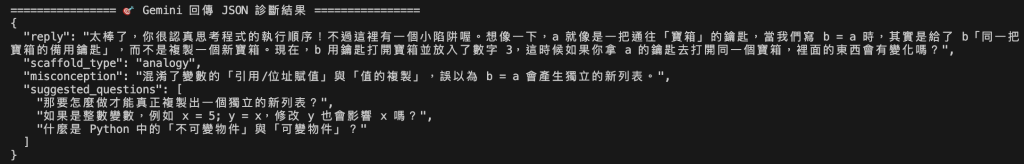
學生錯誤輸入:

Gemini API 診斷結果:
如果放到真正的教學場景裡,一個老師同時面對 30 個學生,很難知道每個學生到底為什麼會錯。
有些人是公式不熟,有些人是觀念搞錯,也有人只是把兩個不同的概念混在一起。
而且有些學生就算不懂,也不一定會主動問老師。所以如果 AI 可以把學生的錯誤回答整理成 misconception,那它就不只是「幫學生解題」,而是開始累積學生的學習歷程。
或許未來把這些資料存進 Firebase Firestore,就可以進一步做出:
「這個學生最近一直卡在異分母運算。」
甚至從個人延伸到整個班級:
「全班有 70% 的學生都在這個觀念上出現問題。」
老師就可以根據這些資料,決定下一堂課到底要不要重新講一次這個觀念。
這樣才比較接近我原本想做的「適性學習」:不是所有學生都收到一模一樣的答案,而是根據他現在卡住的地方,給他不同的引導。
今天我們先讓 Professor Spark 學會「找出學生為什麼錯」。
但如果真的要讓學生使用,除了教學效果之外,安全性也不能忽略。
所以明天 Day 06 就要進入下一個階段:安全機制
我們會開始設定 Google AI Studio 的 Safety Settings,測試不同安全防護設定對 Gemini 回應的影響,讓AI助教不只是會教,還能成為一個更適合學生使用的 AI 學習環境。


 iThome鐵人賽
 看影片追技術